
Spanner:Google 的全球分布式数据库
本篇是论文 Spanner: Google’s Globally-Distributed Database 的中文翻译,尽量保持原文的章节顺序与表述。
本篇是论文 Spanner: Google’s Globally-Distributed Database 的中文翻译,尽量保持原文的章节顺序与表述。
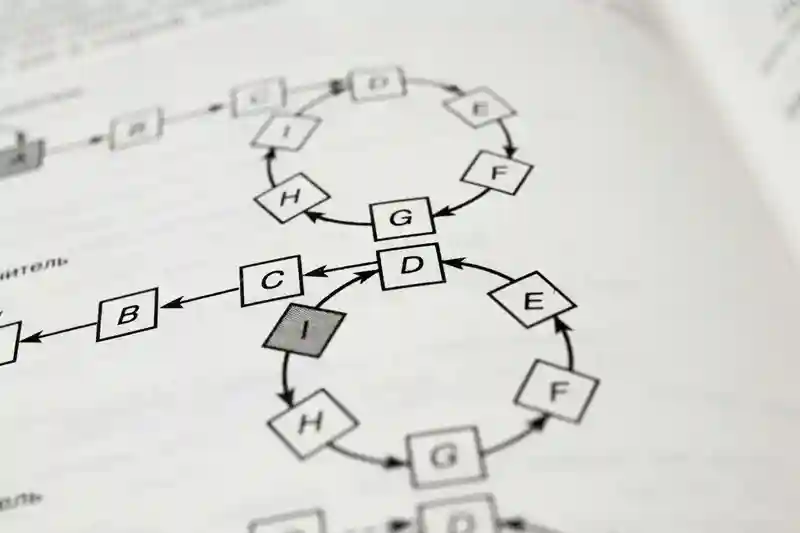
拓扑排序(Topological Sorting)是一个有向无环图(DAG, Directed Acyclic Graph)的所有顶点的线性序列。且该序列必须满足下面两个条件:
graph TD
id1((1)) --> id2((2))
id1((1)) --> id4((4))
id2((2)) --> id4((4))
id4((4)) --> id3((3))
id2((2)) --> id3((3))
id4((4)) --> id5((5))
id3((3)) --> id5((5))
有向无环图(DAG)才有拓扑排序,非DAG图没有拓扑排序一说。
shell 脚本选项参数解析通常有 3 种方法。
布尔基础:
逻辑表达式: 由逻辑变量和与 $\land$ ,或 $\lor$ ,非 $\neg$ 3种运算符连接所构成的表达式。
析取式: 表达式之间都通过逻辑或连接的复合表达式。
合取式: 表达式之间都通过逻辑与连接的复合表达式。
合取范式 (Conjunctive Normal Form)2 是命题公式的一个标准型,它由一系列析取子句 用合取操作连接而来。如 $(a) \land (a \lor \neg c) \land (b \lor c)$
与之相反,析取范式 (Disjunctive Normal Form) 是命题公式的另一个标准型,它由一系列 合取子句 用 析取操作 连接而来。如 $(a) \lor (a \land \neg c) \lor (b \land c)$
表达式化简:
JMH 是openJDK项目下的JVM工具,用于构建,运行和分析用Java和其他语言编写的针对JVM的nano/micro/milli/macro微基准测试。
随着多核芯片的广泛使用,线程是提升性能的首选方案。适当提升一点线程数会很好;事实上,拥有太多线程可能会使程序陷入困境。过多的线程主要对两个方面有影响:
split命令可以将一个大文件分割成很多个小文件,有时需要将文件分割成更小的片段,比如为提高可读性,生成日志等。
本文是学习flink源码前的准备工作。在开始之前,先做好准备工作:
版本格式:主版本号.次版本号.修订号,版本号递增规则如下:
先行版本号及版本编译元数据可以加到主版本号.次版本号.修订号 的后面,作为延伸。
生命游戏是英国数学家约翰·何顿·康威在1970年发明的细胞自动机。